
Doe v. GitHub nació de una pregunta aparentemente sencilla: ¿qué ocurre cuando una herramienta de inteligencia artificial genera código parecido al publicado por un programador, pero omite sus avisos de copyright o atribución? Los demandantes sostuvieron que GitHub, Microsoft y OpenAI habían empleado enormes cantidades de código disponible en repositorios públicos para desarrollar Copilot y Codex.
La controversia llegó al Noveno Circuito bajo una teoría basada en la sección 1202 de la DMCA, norma que prohíbe determinadas conductas relacionadas con la remoción o alteración deliberada de información de gestión de copyright. El tribunal, sin embargo, concluyó que una salida generada por un modelo que nunca incluyó esa información no equivale necesariamente a una obra de la cual dicha información haya sido “removida”. Instituto de Información Legal
Esta distinción cerró una vía relevante de responsabilidad, pero no convirtió el entrenamiento de IA en una actividad jurídicamente libre. El fallo dejó abiertas cuestiones relacionadas con copyright ordinario, contratos, licencias y la forma en que los materiales fueron incorporados al sistema. El propio informe base destaca que el efecto estratégico de Doe fue desplazar el litigio desde los daños asociados a la ausencia de CMI hacia los inputs y los outputs.
Por ello, el verdadero legado de Doe v. GitHub no consiste en haber reducido el riesgo de la inteligencia artificial, sino en haberlo redistribuido a lo largo de toda su cadena de desarrollo: adquisición de datos, entrenamiento, licenciamiento, generación y comercialización.
El primer error al analizar estos conflictos consiste en considerar al entrenamiento de IA como un único acto jurídico. En realidad, existen varias etapas: obtención del material, almacenamiento, preparación del dataset, entrenamiento, ajuste del modelo y generación de resultados. La U.S. Copyright Office ha señalado que las distintas formas de utilización de obras protegidas durante el desarrollo de sistemas generativos deben analizarse atendiendo a sus circunstancias específicas. Oficina de Derechos de Autor de EE. UU.
La segunda variable es la licencia. Que un repositorio sea públicamente accesible no significa que su código esté libre de condiciones. Licencias como MIT, Apache o GPL permiten distintos niveles de reutilización, pero pueden imponer obligaciones relacionadas con atribución, avisos legales, redistribución o acceso al código fuente. Precisamente por ello, el conflicto de Copilot trasciende el copyright tradicional y alcanza también al derecho contractual.
Esta diferencia resulta todavía más importante en el ámbito de la IA abierta. “Código abierto”, “pesos abiertos” e “IA de código abierto” no son conceptos necesariamente equivalentes. La Open Source AI Definition 1.0 de la Open Source Initiative exige libertades para usar, estudiar, modificar y compartir el sistema, además del acceso a los elementos necesarios para hacerlo efectivamente. Open Source Initiative
El resultado es una arquitectura jurídica mucho más compleja. Un desarrollador puede tener permiso para acceder a una obra, restricciones para reutilizarla, argumentos de fair use respecto del entrenamiento y, al mismo tiempo, problemas independientes si el modelo reproduce posteriormente elementos protegidos. No existe una única pregunta sobre copyright de IA, sino varias preguntas encadenadas.
La sentencia del Noveno Circuito en Doe v. GitHub se concentró en una cuestión específica: si la ausencia de información de gestión de copyright en una salida generada podía considerarse una “remoción” bajo §1202(b). La Corte concluyó que la teoría presentada por los demandantes no satisfacía ese requisito cuando el sistema generaba una nueva salida que nunca había contenido originalmente la información. Corte de Apelaciones del Noveno Circuito
Pero el fallo no decidió si sería jurídicamente distinto eliminar avisos, atribuciones o metadatos antes de incorporar una obra al conjunto de entrenamiento. De hecho, el expediente base identifica esta cuestión como una posible “teoría de entrada” que no llegó a resolverse sustantivamente en apelación. Del Código Fuente al Mercado_ C… Por tanto, la procedencia y preparación de los datasets continúa siendo uno de los principales frentes de riesgo.
Esta tendencia se observa claramente en Bartz v. Anthropic. Allí, el debate distinguió entre el uso de obras para entrenar un modelo y la obtención de determinados libros desde bibliotecas piratas. El litigio terminó en un acuerdo colectivo de USD 1.500 millones, cuya aprobación definitiva fue otorgada en julio de 2026. La resolución de aprobación final del acuerdo puede consultarse aquí. Justia Law
El precedente transmite una advertencia empresarial concreta: incluso cuando pueda existir una defensa respecto del propósito transformador del entrenamiento, la forma de adquisición del material puede generar responsabilidad independiente. El riesgo comienza, por tanto, antes de que el modelo sea entrenado.
Dos arquitecturas tecnológicas, dos mapas de riesgo
Para los desarrolladores de IA propietaria, el riesgo se concentra especialmente en la gobernanza de grandes conjuntos privados de entrenamiento. Cuanto mayor sea el corpus, mayor será la necesidad de documentar procedencia, autorizaciones, exclusiones y licencias. La trazabilidad se convierte así en un mecanismo de defensa jurídica además de una práctica técnica.
Los proveedores cerrados cuentan, sin embargo, con una ventaja estructural: pueden centralizar sus procesos de cumplimiento. Auditorías internas, acuerdos de licencia, filtros de contenido y mecanismos contractuales de indemnización pueden administrarse desde una sola organización. El costo puede ser elevado, pero también existe una mayor capacidad de control.
Los sistemas abiertos distribuyen el problema. Un modelo puede ser desarrollado por una organización, modificado por otra, ajustado con nuevos datos por un tercero e integrado finalmente en un producto comercial. En esa cadena pueden coexistir licencias sobre código, datasets, documentación y otros componentes. El riesgo jurídico deja de estar concentrado y se desplaza entre múltiples actores.
Doe resulta especialmente relevante en este contexto porque las reclamaciones contractuales relacionadas con licencias de código abierto no desaparecieron con la decisión sobre la DMCA. El documento base señala expresamente que dichas reclamaciones continuaron siendo una vía jurídicamente relevante. Del Código Fuente al Mercado_ C… Así, que un modelo sea “abierto” no significa que sus usuarios puedan ignorar las obligaciones jurídicas heredadas de los componentes utilizados para desarrollarlo.
El verdadero activo de la IA ya no es solo el modelo: es su trazabilidad
El litigio de inteligencia artificial está evolucionando desde preguntas abstractas hacia interrogantes mucho más probatorios. Ya no basta con discutir si “entrenar una IA” constituye fair use. Los tribunales comienzan a observar qué obras fueron utilizadas, de dónde provinieron, con qué finalidad fueron copiadas y qué efecto puede producir el sistema sobre el mercado de esas obras.
La posición de la U.S. Copyright Office sobre entrenamiento generativo refuerza esta aproximación contextual. La institución no propone una regla universal según la cual todo entrenamiento sea lícito o ilícito; considera que la evaluación depende de factores como el propósito de la utilización, las características de las obras y sus efectos económicos. Oficina de Derechos de Autor de EE. UU.
En este entorno, los departamentos jurídicos necesitarán trabajar cada vez más cerca de desarrolladores, ingenieros y especialistas en datos. Registrar la procedencia de un dataset, identificar sus licencias o conservar información sobre las transformaciones aplicadas puede parecer inicialmente una tarea técnica, pero esas evidencias pueden convertirse posteriormente en elementos decisivos dentro de un litigio.
El cambio fundamental es, por tanto, de gobernanza. El valor jurídico de un sistema de IA no dependerá únicamente de su capacidad para generar buenos resultados, sino también de que su desarrollador pueda reconstruir documentalmente cómo fue construido.
Del “la IA lo generó” al “demuestre cómo llegó hasta allí”
Doe v. GitHub no creó una excepción general para la inteligencia artificial frente al copyright. Su alcance fue más limitado: determinó que determinadas salidas generativas no podían considerarse automáticamente obras de las cuales se hubiera removido información de gestión de derechos bajo §1202(b). Corte de Apelaciones del Noveno Circuito
Sin embargo, esa limitación desplazó el litigio hacia cuestiones potencialmente más profundas. La adquisición de datasets, el cumplimiento de licencias, la reproducción de obras y los efectos económicos de los outputs se están convirtiendo en los verdaderos puntos de conflicto.
Para la IA propietaria, ello exige mayor control y documentación sobre sus fuentes de entrenamiento. Para los ecosistemas abiertos, exige además comprender cómo se transmiten obligaciones jurídicas entre desarrolladores, modelos, componentes y productos derivados.
La principal enseñanza de Doe v. GitHub puede resumirse entonces en una transformación conceptual: el riesgo jurídico de la IA ya no se encuentra únicamente en lo que genera el modelo, sino en toda la historia jurídica que permitió construirlo. En el mercado de la inteligencia artificial, la trazabilidad de datos y licencias empieza a ser tan estratégica como el propio código.
Bibliografía
United States Court of Appeals for the Ninth Circuit. (2026). Doe v. GitHub, Inc., No. 24-7700. Consultar sentencia oficial.
U.S. Copyright Office. (2025). Copyright and Artificial Intelligence, Part 3: Generative AI Training. Consultar informe oficial.
United States Congress / Cornell Legal Information Institute. 17 U.S.C. §1202 – Integrity of Copyright Management Information. Consultar disposición legal.
United States District Court for the Northern District of California. (2026). Bartz et al. v. Anthropic PBC, Document 680, Order Granting Final Approval of Class Action Settlement. Consultar resolución.
United States District Court for the Northern District of California. (2025). Kadrey et al. v. Meta Platforms, Inc., Document 598. Consultar decisión judicial.
Open Source Initiative. (2024). The Open Source AI Definition 1.0. Consultar definición.
U.S. Copyright Office. Artificial Intelligence Initiative. Consultar portal institucional sobre IA y copyright.
Cada interacción digital genera información. Una compra electrónica, una aplicación móvil, una plataforma de inteligencia artificial o un sistema de reconocimiento facial pueden registrar no solo nombres o números de identificación, sino también preferencias, hábitos, ubicaciones y patrones de comportamiento. La protección de datos, por tanto, ya no se limita a mantener información en secreto: busca determinar quién puede utilizarla, para qué finalidad, durante cuánto tiempo y bajo qué garantías.
En Ecuador, este derecho tiene reconocimiento constitucional y se desarrolla mediante la Ley Orgánica de Protección de Datos Personales (LOPDP), vigente desde 2021. La ley regula tratamientos automatizados y no automatizados y reconoce principios, derechos y obligaciones para responsables y encargados. Superintendencia de Datos a escala internacional, el Reglamento General de Protección de Datos de la Unión Europea (RGPD) constituye uno de los principales referentes regulatorios y consolida principios como licitud, transparencia, minimización, limitación de finalidad, seguridad y responsabilidad.
Un dato personal es cualquier información relacionada con una persona identificada o identificable. Por ello, la protección no se limita al nombre o al número de cédula: también puede comprender identificadores digitales, ubicación, comportamiento en línea o diferentes datos que, combinados, permitan reconocer a una persona. La Comisión Europea utiliza esta misma aproximación al explicar que incluso información seudonimizada puede continuar siendo dato personal cuando exista posibilidad de reidentificación. European Commission
La protección se intensifica frente a categorías particularmente delicadas, como información de salud, genética o biométrica. Sobre estos tratamientos operan principios como licitud, finalidad, proporcionalidad, minimización, transparencia, seguridad y responsabilidad proactiva. El consentimiento sigue siendo relevante, pero no representa una autorización universal: debe ser libre, específico, informado e inequívoco. Las Directrices 05/2020 del Comité Europeo de Protección de Datos sobre consentimiento insisten precisamente en estas condiciones. Junta Europea de Protección de Datos
En Ecuador, el sistema se estructura fundamentalmente alrededor de la LOPDP y su Reglamento General. A estas normas se suman las regulaciones emitidas progresivamente por la Superintendencia de Protección de Datos Personales. La sección oficial de resoluciones de la SPDP muestra cómo durante 2025 y 2026 la autoridad desarrolló reglas sobre evaluaciones de riesgo, contratos, transferencias internacionales, anonimización, tratamiento a gran escala, inteligencia artificial, biometría y vulneraciones de seguridad. Superintendencia de Datos
Particular importancia tiene la Resolución SPDP-SPD-2026-0037-R, que reformó la regulación ecuatoriana sobre inteligencia artificial. La norma utiliza los conceptos de acceso, visibilidad y control efectivo sobre los datos para determinar el alcance de determinadas responsabilidades. El documento de análisis proporcionado explica que este enfoque desplaza la atención desde la mera posesión formal de información hacia la capacidad real de conocer, influir o intervenir en el tratamiento y en sus resultados.
En perspectiva comparada, el RGPD mantiene una lógica similar mediante el principio de accountability: las organizaciones no solo deben respetar las reglas, sino estar en condiciones de demostrar su cumplimiento. La Comisión Europea identifica siete principios centrales del régimen europeo, entre ellos limitación de finalidad, minimización, seguridad y responsabilidad. European Commission
Los titulares poseen derechos que les permiten recuperar cierto control sobre la utilización de su información. Entre ellos se encuentran acceso, rectificación, eliminación, oposición, portabilidad y garantías frente a determinadas decisiones automatizadas. El RGPD reconoce igualmente derechos de acceso, rectificación, supresión, restricción, portabilidad, oposición y protección frente a decisiones exclusivamente automatizadas. European Commission
Para responsables y encargados, estos derechos se traducen en obligaciones organizativas. No basta con disponer de una política de privacidad: las empresas deben conocer qué información poseen, determinar su base jurídica, limitar los accesos, definir periodos de conservación, controlar a sus proveedores, implementar medidas de seguridad y conservar evidencia sobre las decisiones adoptadas.
La gestión de vulneraciones muestra con claridad este cambio. La Resolución SPDP-SPD-2026-0040-R, incluida en el catálogo oficial de la SPDP, establece una normativa específica para las notificaciones de vulneraciones de seguridad. Superintendencia de Datos Según el documento aportado, el encargado debe comunicar determinados incidentes al responsable dentro de un máximo de dos días hábiles y el responsable dispone de cinco días hábiles para realizar la correspondiente notificación ante la SPDP; cuando exista riesgo para los titulares, también debe comunicárseles sin demora.
La inteligencia artificial cambia la naturaleza del problema porque ya no solo utiliza datos existentes: también puede inferir nueva información. Un sistema puede construir perfiles, detectar patrones o producir clasificaciones sin necesidad de acceder de manera visible a todos los datos originales. Por ello, el concepto ecuatoriano de “control efectivo” resulta particularmente relevante: la responsabilidad puede vincularse con la capacidad técnica, contractual u organizativa de influir sobre los datos, el tratamiento o los resultados del sistema.
La biometría constituye otro escenario crítico. La Resolución SPDP-SPD-2026-0039-R, oficialmente listada por la Superintendencia, establece una regulación específica para este tratamiento. Superintendencia de Datos La norma parte de la especial sensibilidad de características como rostro, huellas, voz o iris cuando permiten identificar unívocamente a una persona. El análisis suministrado señala además la obligación de evaluar riesgos, realizar evaluaciones de impacto y, en determinados tratamientos fundamentados en consentimiento, ofrecer alternativas no biométricas.
El desafío se amplía en servicios en la nube, comercio electrónico y redes sociales. Una organización puede captar información mediante una aplicación, almacenarla con un proveedor externo, procesarla mediante otro servicio y posteriormente utilizarla con herramientas de inteligencia artificial. En consecuencia, proteger datos implica controlar toda la cadena tecnológica. Esta visión coincide con el NIST Privacy Framework, que plantea la privacidad como parte integral de la gestión empresarial del riesgo.
La principal transformación del derecho de protección de datos es que el cumplimiento está dejando de evaluarse únicamente a través de documentos formales. Una organización puede tener contratos, avisos de privacidad y formularios de consentimiento y, aun así, mantener graves deficiencias si desconoce sus flujos de información o no puede demostrar cómo controla a sus proveedores.
El documento analizado identifica precisamente esta transición dentro del régimen ecuatoriano: la gobernanza exige auditar proveedores, actualizar contratos, conservar registros, gestionar consentimientos y mantener evaluaciones de impacto y evidencia de debida diligencia. De esta manera, la protección de datos se conecta cada vez más con ciberseguridad, contratación tecnológica, compliance, gestión de riesgos y diseño de productos digitales.
La pregunta relevante deja entonces de ser únicamente “¿tenemos autorización para tratar este dato?” y pasa a ser “¿podemos explicar y demostrar por qué necesitamos tratarlo, quién interviene y qué controles hemos implementado?”. Ese cambio resume el tránsito de la privacidad documental hacia la responsabilidad demostrable.
La protección de datos personales no pretende impedir la innovación tecnológica. Su función consiste en establecer condiciones para que la utilización de información sea legítima, proporcional, transparente y segura. En consecuencia, inteligencia artificial, biometría, servicios en la nube o comercio electrónico no son incompatibles con la privacidad, pero requieren una gobernanza capaz de identificar y controlar sus riesgos.
En Ecuador, la combinación entre la LOPDP y la creciente normativa de la SPDP muestra una evolución hacia una regulación más técnica y preventiva. Las nuevas reglas sobre IA, biometría y vulneraciones de seguridad refuerzan la necesidad de conocer los flujos de datos, controlar proveedores, realizar evaluaciones de riesgo y documentar las decisiones adoptadas. Superintendencia de Datos
La verdadera madurez en protección de datos comienza cuando una organización deja de preguntarse únicamente si puede utilizar determinada información y empieza a preguntarse si puede justificar, proteger y demostrar adecuadamente ese uso. En la economía digital, esa capacidad se convierte tanto en una obligación jurídica como en un elemento estratégico de confianza.
Asamblea Nacional del Ecuador. (2021). Ley Orgánica de Protección de Datos Personales. Registro Oficial Suplemento 459. Texto de la LOPDP. Superintendencia de Datos
Presidencia de la República del Ecuador. (2023). Reglamento General a la Ley Orgánica de Protección de Datos Personales. Decreto Ejecutivo No. 904. Consultar el Reglamento General.
Superintendencia de Protección de Datos Personales. (2026). Resoluciones y normativa de protección de datos personales. Repositorio oficial de resoluciones de la SPDP. Superintendencia de Datos
Parlamento Europeo y Consejo de la Unión Europea. (2016). Reglamento (UE) 2016/679 — Reglamento General de Protección de Datos. Texto oficial del RGPD en EUR-Lex.
European Data Protection Board. (2020). Directrices 05/2020 sobre el consentimiento en el sentido del Reglamento (UE) 2016/679. Consultar las directrices del EDPB. Junta Europea de Protección de Datos
European Commission. Principles of the GDPR. Principios del Reglamento General de Protección de Datos. European Commission
Boeckl, K. & Lefkovitz, N. (2020). NIST Privacy Framework: A Tool for Improving Privacy through Enterprise Risk Management. National Institute of Standards and Technology. NIST Privacy Framework.
La información personal se ha convertido en un activo esencial para empresas, instituciones públicas y plataformas digitales. Cada compra electrónica, aplicación móvil, servicio financiero o interacción en redes sociales puede generar información susceptible de identificar, clasificar o perfilar a una persona. Por esta razón, la protección de datos ya no puede entenderse únicamente como protección de la intimidad: supone también otorgar a los individuos capacidad de decisión y control sobre el tratamiento de su información.
En Ecuador, este derecho encuentra fundamento constitucional y ha sido desarrollado principalmente mediante la Ley Orgánica de Protección de Datos Personales (LOPDP), publicada en 2021. La norma establece principios, derechos, obligaciones y mecanismos destinados a garantizar la protección de la información personal durante todo su ciclo de vida. Asamblea Nacional del Ecuador Consultar la Ley Orgánica de Protección de Datos Personales
Sin embargo, la transformación tecnológica obliga a ampliar la discusión. Actualmente no basta con conocer quién almacena los datos: es necesario analizar para qué se recopilan, durante cuánto tiempo se conservan, qué proveedores pueden acceder a ellos, si atraviesan fronteras y qué algoritmos intervienen en su utilización. La protección de datos se transforma así en un problema de gobernanza del riesgo digital.
Un dato personal es toda información que permite identificar o hacer identificable, directa o indirectamente, a una persona. Esto comprende información evidente —nombre, identificación, dirección o correo electrónico—, pero también identificadores digitales, registros de ubicación, comportamientos y combinaciones de información capaces de individualizar a alguien.
La protección aumenta cuando se utilizan datos sensibles o categorías especialmente protegidas, porque su explotación puede generar consecuencias especialmente graves. Información relacionada con salud, biometría, genética, orientación sexual, origen étnico o determinados grupos vulnerables exige controles reforzados. La legislación ecuatoriana diferencia además las categorías de información al momento de evaluar el nivel de riesgo de un tratamiento. Superintendencia de Datos
Sobre estas categorías operan principios esenciales: licitud, transparencia, finalidad, pertinencia, proporcionalidad, minimización, seguridad y responsabilidad proactiva. La consecuencia práctica es importante: que una organización pueda recopilar información no significa que pueda utilizarla indefinidamente o para cualquier propósito. La finalidad debe encontrarse determinada y el tratamiento debe limitarse a aquello que resulte necesario.
El régimen ecuatoriano se estructura principalmente sobre la LOPDP y su Reglamento General, expedido mediante Decreto Ejecutivo 904 en noviembre de 2023. Registro Oficial Consultar el Reglamento General de la LOPDP A este marco se ha incorporado progresivamente normativa secundaria expedida por la Superintendencia de Protección de Datos Personales (SPDP).
Particularmente relevante ha sido la regulación adoptada durante 2026. La SPDP ha expedido normas sobre transferencias nacionales e internacionales, tratamientos a gran escala, biometría, vulneraciones de seguridad y sistemas de inteligencia artificial. La Resolución SPDP-SPD-2026-0009-R, posteriormente reformada, establece reglas específicas para organizaciones que desarrollen, entrenen, implementen o utilicen sistemas de IA que traten datos de titulares ecuatorianos. Superintendencia de Datos Consultar las resoluciones de la SPDP
En el plano internacional, el principal referente continúa siendo el Reglamento General de Protección de Datos de la Unión Europea (RGPD). El Reglamento (UE) 2016/679 consolidó conceptos como responsabilidad proactiva, minimización, protección desde el diseño, evaluaciones de impacto y portabilidad. EUR-Lex Consultar el Reglamento General de Protección de Datos Esta convergencia demuestra que la protección de datos funciona cada vez menos como una cuestión puramente territorial y más como una disciplina vinculada con ecosistemas digitales transfronterizos.
Los titulares poseen derechos que les permiten recuperar cierto grado de control sobre la información que circula sobre ellos. Entre estos se encuentran el acceso, rectificación, actualización, eliminación, oposición y portabilidad, además de garantías relacionadas con decisiones automatizadas. La tradicional denominación ARCO sigue siendo útil como referencia comparada, aunque las legislaciones contemporáneas han ampliado considerablemente el catálogo de derechos.
Del otro lado aparecen las obligaciones de responsables y encargados. Las organizaciones deben justificar jurídicamente sus tratamientos, adoptar medidas administrativas y tecnológicas de seguridad, controlar a sus proveedores, atender derechos, documentar sus operaciones y evaluar los riesgos asociados con determinados tratamientos. La responsabilidad proactiva cambia la pregunta tradicional: ya no basta con afirmar que se cumple la normativa, sino que debe ser posible demostrar cómo se cumple.
Esta lógica resulta especialmente importante frente a una vulneración de seguridad. Una brecha puede generar fraude, robo de identidad, suplantaciones, campañas de phishing o exposición de información sensible. Por ello, gestionar datos personales implica gestionar también las consecuencias que su pérdida, alteración o divulgación podría generar sobre las personas.
La inteligencia artificial introduce una nueva capa de complejidad. Los sistemas pueden procesar enormes cantidades de información, generar inferencias, elaborar perfiles y participar en decisiones automatizadas. El European Data ProtectionBoard (EDPB) ha examinado específicamente cuestiones como la utilización de datos personales para desarrollar modelos, la anonimización y la aplicación del interés legítimo en su Opinión 28/2024 sobre modelos de IA. Junta Europea de Protección de Datos Consultar la Opinión 28/2024 del EDPB sobre IA y datos personales
El riesgo tampoco procede únicamente de la utilización legítima de IA. En septiembre de 2026, la Agencia Española de Protección de Datos informó sobre la primera notificación recibida en España de una brecha en la que el ataque habría sido ejecutado mediante un agente de inteligencia artificial. La documentación analizada describe una secuencia que incluyó identificación de vulnerabilidades, utilización de credenciales válidas, exploración autónoma y posterior acceso o modificación de información. La AEPD ha utilizado posteriormente el caso para advertir sobre la capacidad de la IA ofensiva para acelerar los ataques y reducir los tiempos disponibles para responder. Agencia Española de Protección de DatosConsultar el análisis de la AEPD sobre IA y brechas de datos
Existe además otro riesgo menos visible: la cadena de suministro de datos. Servicios en la nube, CRM, call centers, plataformas publicitarias y proveedores tecnológicos pueden intervenir en un mismo tratamiento. El documento aportado para este análisis examina precisamente un incidente mexicano relacionado con la oferta de aproximadamente 12,9 millones de registros y las dificultades para determinar el origen dentro de una cadena de proveedores. La lección jurídica resulta particularmente relevante: externalizar un servicio no equivale a externalizar automáticamente la responsabilidad sobre los datos.
Uno de los mayores problemas del ecosistema digital es considerar que el consentimiento resuelve por sí mismo cualquier tratamiento. La acumulación de políticas de privacidad, banners y casillas de aceptación puede producir una apariencia formal de control sin garantizar una verdadera comprensión de las consecuencias. Por ello, la legitimidad debe analizarse conjuntamente con necesidad, finalidad, proporcionalidad y transparencia.
La inteligencia artificial hace todavía más evidente esta limitación. Resulta necesario determinar qué datos alimentan un sistema, qué inferencias produce, qué decisiones puede adoptar y qué consecuencias genera sobre los individuos. La regulación ecuatoriana específica sobre sistemas de IA responde precisamente a esa necesidad de trasladar los principios tradicionales de protección de datos a tecnologías capaces de operar de manera automatizada. Superintendencia de Datos
La discusión contemporánea, por tanto, no debería plantearse como una confrontación entre innovación y privacidad. El verdadero desafío consiste en diseñar tecnologías y modelos empresariales donde el tratamiento de datos sea jurídicamente legítimo, técnicamente seguro y proporcional al objetivo perseguido.
La protección de datos personales ha dejado de ser una obligación periférica para convertirse en un elemento estructural de la transformación digital. Inteligencia artificial, automatización, servicios en la nube y ecosistemas de terceros amplían las posibilidades de utilización de la información, pero también incrementan la superficie de riesgo.
El cumplimiento efectivo exige integrar protección desde el diseño, análisis de riesgos, controles de seguridad, gestión contractual, ejercicio de derechos y documentación. Una política de privacidad o una casilla de consentimiento pueden formar parte del sistema, pero difícilmente pueden sustituir una arquitectura integral de gobernanza.
En este escenario, la principal transformación es conceptual: proteger datos no significa impedir su utilización, sino establecer las condiciones jurídicas y técnicas para utilizarlos responsablemente. La confianza digital dependerá cada vez más de la capacidad de las organizaciones para demostrar que innovación y protección de derechos forman parte del mismo diseño.
Asamblea Nacional del Ecuador. (2021). Ley Orgánica de Protección de Datos Personales. Registro Oficial No. 459, Quinto Suplemento, 26 de mayo de 2021. Ley Orgánica de Protección de Datos Personales — fuente oficial
Presidencia de la República del Ecuador. (2023). Reglamento General de la Ley Orgánica de Protección de Datos Personales. Decreto Ejecutivo No. 904, Registro Oficial No. 435. Reglamento General de la LOPDP — Registro Oficial
Superintendencia de Protección de Datos Personales. (2026). Resolución N.º SPDP-SPD-2026-0009-R: Norma General para la Garantía del Derecho de Protección de Datos Personales en el Uso de Sistemas de Inteligencia Artificial, y normativa secundaria relacionada. Repositorio oficial de resoluciones de la SPDP
Parlamento Europeo y Consejo de la Unión Europea. (2016). Reglamento (UE) 2016/679 — Reglamento General de Protección de Datos. EUR-Lex. Texto oficial del RGPD en español
European Data Protection Board. (2024). Opinion 28/2024 on Certain Data Protection Aspects Related to the Processing of Personal Data in the Context of AI Models. EDPB. Opinión 28/2024 sobre IA y datos personales
Agencia Española de Protección de Datos. (2026). Primera notificación de una brecha de datos personales causada por un ataque ejecutado mediante un agente de IA e IA ofensiva: cuando la inteligencia artificial acelera el riesgo para la protección de datos. AEPD. Publicaciones de la AEPD sobre IA y brechas de datos
La discusión sobre inteligencia artificial y derechos de autor está entrando en una etapa distinta. El debate ya no gira únicamente alrededor de si una empresa puede utilizar obras protegidas para entrenar un modelo o si determinados usos pueden considerarse transformadores. Los nuevos litigios comienzan a mirar hacia otro lugar: quién tomó las decisiones, cómo se obtuvieron los contenidos y qué controles existían dentro de la empresa.
La demanda presentada el 28 de agosto de 2026 por Sony Music Publishing, Warner Chappell Music y otras editoriales contra Anthropic ilustra este cambio. El proceso, presentado ante el Tribunal Federal del Distrito Norte de California, no solo incluye a Anthropic PBC como demandada, sino también a su CEO y cofundador Dario Amodei y al cofundador Benjamin Mann.
Para las empresas que desarrollan o incorporan inteligencia artificial, el caso introduce una cuestión relevante: la propiedad intelectual está dejando de ser exclusivamente un problema del departamento legal para convertirse también en un asunto de gobierno corporativo.
Sony y Warner alegan que Anthropic habría obtenido miles de composiciones musicales mediante distintos mecanismos, incluyendo descargas desde fuentes piratas, torrenting y extracción de letras desde plataformas digitales. Estas afirmaciones todavía deben ser probadas dentro del proceso y Anthropic ha manifestado que se defenderá de las acusaciones.
Lo interesante desde la perspectiva de enforcement es la estructura de la reclamación. Los demandantes no se limitan a cuestionar qué aprendió Claude de esas obras o qué puede generar posteriormente. Buscan reconstruir la cadena completa de decisiones que permitió que determinados contenidos llegaran hasta los sistemas de la compañía.
El documento analizado sostiene precisamente que la estrategia de los demandantes combina acusaciones sobre adquisición de contenido con la inclusión de los fundadores como demandados, a quienes atribuye participación directa en las decisiones cuestionadas.
Esto no significa que exista responsabilidad personal establecida. El proceso apenas comienza. Pero sí demuestra hacia dónde puede evolucionar el litigio en materia de inteligencia artificial: del funcionamiento del modelo hacia las personas, procedimientos y decisiones que hicieron posible su entrenamiento.
Para una empresa, esta diferencia es importante. Imaginemos una compañía que desarrolla un sistema generativo y adquiere millones de archivos mediante proveedores externos. Si posteriormente aparecen obras protegidas dentro del conjunto de entrenamiento, las preguntas jurídicas no necesariamente terminarán en “¿quién programó el modelo?”.
También podrían surgir otras: ¿quién autorizó la adquisición del dataset?, ¿qué controles existían para verificar su origen?, ¿se conocían las restricciones de las fuentes?, ¿hubo alertas internas?, ¿quién decidió continuar utilizando esa información?
Es aquí donde la propiedad intelectual empieza a conectarse con el compliance y el gobierno corporativo. La trazabilidad de los datos deja de ser únicamente una buena práctica técnica. Puede convertirse en evidencia para demostrar cómo una organización identificó, evaluó y gestionó determinados riesgos.
El antecedente de Bartz v. Anthropic ya había mostrado la importancia de diferenciar actos dentro de una misma cadena tecnológica: en 2025, el juez William Alsup distinguió el entrenamiento de modelos de la creación y conservación de una biblioteca formada mediante copias provenientes de sitios piratas. Esa distinción ya fue ampliamente discutida en torno al fair use. La nueva demanda avanza un paso más: pregunta quién estuvo detrás de esas decisiones.
Otro elemento particularmente interesante de la demanda es la denominada Copyright Management Information (CMI), o información de gestión de derechos de autor.
Esta información puede identificar, entre otros elementos, el título de una obra, su autor, el titular de derechos o determinadas condiciones de utilización. La legislación estadounidense contempla específicamente supuestos relacionados con su eliminación o alteración sin autorización cuando concurren los requisitos establecidos por la ley.
Sony y Warner alegan que parte de esta información habría sido eliminada durante el procesamiento de los contenidos.
Desde una perspectiva empresarial, este punto trasciende el litigio concreto. En sistemas capaces de procesar millones de archivos, los metadatos no son accesorios: pueden formar parte de la trazabilidad jurídica del activo. Eliminar información durante procesos de limpieza, conversión o preparación de datos sin analizar previamente su función puede generar riesgos distintos de aquellos derivados del uso de la obra propiamente dicha.
Durante mucho tiempo, el enforcement de propiedad intelectual se entendió principalmente como una reacción: identificar una infracción, recopilar evidencia y ejercer acciones contra el responsable.
La inteligencia artificial obliga a ampliar esa lógica. Los titulares necesitan comprender cómo circulan sus contenidos, qué plataformas los recopilan, qué información permanece asociada a ellos y qué actores intervienen en la cadena tecnológica.
Para las empresas desarrolladoras ocurre lo contrario: necesitan poder demostrar la procedencia de sus contenidos, las decisiones adoptadas y los mecanismos utilizados para prevenir incorporaciones no autorizadas.
En Ecuador, el análisis deberá realizarse bajo nuestro propio sistema jurídico. El COESCCI y la Decisión 351 de la Comunidad Andina reconocen la protección de las obras y los derechos patrimoniales de sus titulares, mientras que SENADI ejerce competencias en materia de derechos intelectuales. La doctrina estadounidense del fair use y las conclusiones de sus tribunales no pueden trasladarse automáticamente al ordenamiento ecuatoriano.
La relevancia del caso Sony y Warner contra Anthropic no consiste únicamente en determinar quién ganará el litigio. Su mayor enseñanza está en mostrar cómo está cambiando la estrategia de protección de los derechos intelectuales.
Ya no basta con observar el resultado producido por una inteligencia artificial. El enforcement puede retroceder hasta el origen del dato, reconstruir su recorrido y analizar quién autorizó cada decisión.
Para las empresas, esto convierte la gestión de propiedad intelectual en una cuestión de prevención, documentación y gobierno corporativo. Para los titulares de derechos, abre nuevas herramientas para investigar y estructurar estrategias de protección frente a usos tecnológicos cada vez más complejos.
En este nuevo escenario, innovar y proteger ya no son procesos separados. La capacidad de explicar qué datos se utilizan, de dónde provienen y quién decidió utilizarlos puede convertirse en parte esencial de la defensa jurídica de cualquier proyecto de inteligencia artificial.
La Unión Europea ha decidido asumir un rol protagónico en el debate sobre cómo deben regularse las tecnologías de Inteligencia Artificial (IA). En octubre de 2025, el Reglamento Europeo de Inteligencia Artificial (RIA o AI Act) ya no es un simple proyecto, sino un cuerpo normativo que comienza a desplegar efectos reales. El objetivo declarado es ambicioso: garantizar que la IA se desarrolle y utilice dentro de un marco que respete los derechos fundamentales de las personas. Sin embargo, este esfuerzo también plantea dilemas complejos que van desde la carga regulatoria hasta la interpretación judicial de conceptos aún difusos.
Este avance normativo europeo representa mucho más que un listado de prohibiciones y obligaciones. Es un intento de establecer un pacto social y jurídico alrededor de una tecnología que tiene el potencial de redefinir la vida económica, política y cultural. Y como ocurre en toda iniciativa de gran escala, el impacto no se limita a las fronteras europeas: la sombra de Bruselas alcanza a empresas, gobiernos y tribunales en todo el mundo.
El análisis del RIA nos obliga, entonces, a movernos en dos planos: el técnico, donde se definen riesgos y obligaciones concretas; y el estratégico, donde se juega la competitividad de empresas, el equilibrio regulatorio y el alcance de los derechos de las personas en la era digital.
El RIA estructura la regulación de la IA en función del nivel de riesgo. De este modo, se identifican cuatro categorías: riesgo inaceptable, alto riesgo, riesgo limitado y riesgo mínimo. La idea es sencilla en apariencia: cuanto mayor sea la probabilidad de daño, mayores deben ser los controles. En la práctica, sin embargo, esta clasificación supone un reto para empresas y autoridades que deberán determinar en qué nivel se encuentra cada sistema y cómo cumplir con las obligaciones correspondientes.
Las prácticas consideradas de riesgo inaceptable son especialmente relevantes. Aquí se ubican aquellas aplicaciones que se consideran contrarias a la dignidad y los derechos fundamentales: manipulación subliminal, explotación de vulnerabilidades por edad o discapacidad, sistemas de puntuación social, predicción de delitos a partir de perfiles, creación masiva de bases de datos faciales sin consentimiento, inferencia emocional en espacios laborales o educativos, y el reconocimiento biométrico en tiempo real en lugares públicos. Estos usos están expresamente prohibidos, y su incumplimiento acarrea sanciones económicas que pueden superar los 30 millones de euros o el 7 % de la facturación anual de la empresa.
Por encima de estas prohibiciones, el Reglamento también impone un régimen de obligaciones estrictas para los sistemas de alto riesgo. Estos abarcan desde la gestión de riesgos y la calidad de los datos de entrenamiento hasta la documentación técnica, la trazabilidad y la supervisión humana. El propósito es garantizar que las decisiones de la IA no queden en la opacidad, sino que exista un rastro verificable que permita comprender cómo y por qué un sistema toma determinada decisión. Incluso los modelos de propósito general — capaces de ser utilizados en múltiples aplicaciones — están sujetos a reglas específicas, como reportar incidentes, documentar los conjuntos de entrenamiento y establecer protocolos de seguridad.
Uno de los mayores desafíos del RIA es cómo equilibrar la innovación con la protección de derechos fundamentales. Si bien la intención de la Unión Europea es clara, existe el riesgo de que el exceso de carga regulatoria afecte la competitividad de las startups y pequeñas empresas tecnológicas. Estas carecen, en muchos casos, de los recursos necesarios para implementar auditorías, documentar procesos y sostener el nivel de cumplimiento exigido. Por contraste, los grandes actores tecnológicos cuentan con departamentos legales y técnicos que les permiten absorber con mayor facilidad estas exigencias.
Además, el Reglamento plantea problemas de interpretación conceptual. ¿Qué se entiende exactamente por manipulación subliminal? ¿Hasta dónde una estrategia de personalización de contenido deja de ser legítima y pasa a convertirse en explotación de vulnerabilidades? Estas preguntas no son triviales. El modo en que los tribunales y autoridades interpreten estas disposiciones determinará el alcance real del RIA y la seguridad jurídica de las empresas. La ambigüedad puede derivar en disputas judiciales complejas y en la necesidad de que el Tribunal de Justicia de la Unión Europea siente precedentes.
El carácter extraterritorial del RIA también genera interrogantes. Aunque es una norma europea, su aplicación se extiende a proveedores que, aun estando fuera del continente, ofrezcan servicios que impacten en el mercado europeo. Esto obliga a compañías de América Latina, Asia y otras regiones a revisar sus modelos de negocio si pretenden operar con clientes europeos. Sin embargo, ejecutar esta extraterritorialidad no será sencillo: ¿cómo imponer sanciones a empresas sin presencia física en Europa? Esta tensión refleja la ambición de la norma, pero también anticipa conflictos de jurisdicción y de cumplimiento.
Más allá de Europa, el RIA se proyecta como un referente regulatorio internacional. América Latina, por ejemplo, podría ver en este marco un modelo a seguir —aunque con adaptaciones necesarias a sus propias realidades sociales y económicas—. En países donde el debate sobre la regulación de la IA apenas comienza, la experiencia europea puede servir de inspiración, pero también de advertencia sobre las tensiones que acarrea intentar legislar una tecnología en constante evolución.
Para las empresas latinoamericanas, especialmente aquellas que buscan expandirse hacia el mercado europeo, el RIA no es un tema ajeno. Sus obligaciones se convierten en un estándar que deberán cumplir si quieren operar en ese entorno. Esto abre oportunidades para que firmas locales se posicionen como expertas en “IA conforme a Europa”, pero también impone costos que podrían dejar fuera de juego a actores emergentes. El impacto, por tanto, no será solo legal, sino también económico y estratégico.
Por otro lado, el Acta Europea también plantea un mensaje político: Europa quiere liderar la conversación global sobre la ética y el control de la IA. Al igual que ocurrió con el Reglamento General de Protección de Datos (RGPD), el llamado “efecto Bruselas” puede marcar la pauta para otros países y organismos internacionales. Sin embargo, esta ambición también enfrenta riesgos: mientras Europa regula con firmeza, Estados Unidos y Asia podrían avanzar en el desarrollo de IA sin las mismas restricciones, generando un desbalance competitivo.
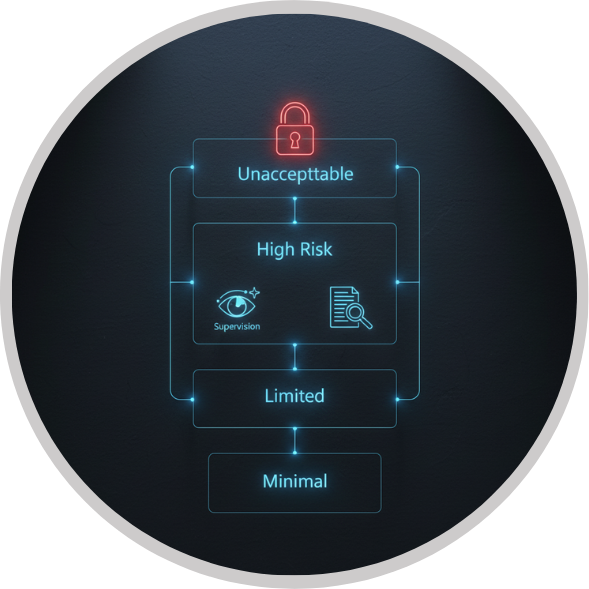
El Acta Europea de Inteligencia Artificial representa una apuesta audaz: construir un marco legal que ponga límites claros al poder de la tecnología sin frenar su potencial transformador. Sus prohibiciones buscan proteger a los ciudadanos de prácticas dañinas, y sus obligaciones intentan garantizar transparencia y responsabilidad en el uso de la IA. Pero al mismo tiempo, la norma abre interrogantes sobre su impacto en la innovación, su viabilidad extraterritorial y la protección real de las víctimas frente a abusos algorítmicos.
Para América Latina, este nuevo marco es tanto una referencia como una advertencia. No basta con copiar el modelo europeo: será necesario adaptarlo a contextos distintos, donde los desafíos de inclusión digital, competitividad y capacidad institucional marcan realidades muy diversas. El reto será aprender de las tensiones europeas y proyectar soluciones propias que equilibren innovación, derechos y desarrollo económico.
En definitiva, el RIA no es un simple reglamento: es el inicio de un pacto regulatorio global en torno a la inteligencia artificial. Y aunque aún queda mucho camino por recorrer, su impacto ya se hace sentir en debates legislativos, en estrategias empresariales y en el modo en que entendemos la relación entre tecnología y derechos en el siglo XXI.
El 25 de septiembre, el juez William Alsup de la Corte Distrital del Norte de California aprobó de forma preliminar un acuerdo que podría convertirse en un hito en la relación entre inteligencia artificial y propiedad intelectual. La tecnológica Anthropic AI aceptó pagar 1.500 millones de dólares para poner fin a la acción colectiva presentada por los autores Andrea Bartz, Inc., Charles Graeber y MJ + KJ, Inc. La acusación: haber entrenado el modelo Claude con cientos de miles de obras literarias obtenidas en sitios pirata.
Aunque se trata de una cifra récord en materia de derechos de autor, representa apenas el 0,82% de la capitalización de mercado de Anthropic. Esta desproporción es la primera señal de alerta: el derecho corre el riesgo de convertirse en un mecanismo que no disuade, sino que legitima la infracción como un costo asumible dentro del plan de negocio.
De acuerdo con los antecedentes del proceso, Anthropic habría efectuado la descarga y almacenamiento de aproximadamente 500.000 libros provenientes de plataformas no autorizadas, entre ellas Library Genesis (LibGen) y Pirate Library Mirror (PiLiMi). Dichos contenidos fueron empleados en el entrenamiento del modelo generativo Claude, sin contar con la autorización de los titulares de derechos.
La cuantía acordada, que se traduce en un promedio estimado de 3.000 dólares por obra utilizada, responde a criterios comparables con precedentes jurisprudenciales en materia de compensaciones por infracción de derechos de autor en jurisdicciones estadounidenses. No obstante, al ser confrontada con la capitalización bursátil de la compañía —estimada en 183.000 millones de dólares—, la reparación aparece desproporcionada en términos de efecto disuasorio.
En este punto, la observación de Jorge Corrales, director general de CEDRO, cobra relevancia al advertir que acuerdos de este tipo podrían convalidar implícitamente un modelo económico sustentado en el aprovechamiento no autorizado de obras protegidas, relegando la retribución de los autores a una instancia meramente indemnizatoria y ex post facto. Desde la perspectiva del derecho de autor, ello plantea un riesgo estructural: la internalización de la infracción como parte del riesgo empresarial previsible, lo cual debilita la función preventiva del sistema normativo.
Más complejo aún es el debate que deja planteado: ¿qué ocurre cuando las obras utilizadas han sido legítimamente adquiridas? La doctrina del fair use en Estados Unidos —el “uso justo” que permite ciertas excepciones a los derechos de autor— abre una puerta que, de validarse, podría cambiar radicalmente el escenario.
La cuestión no es sencilla. ¿Puede considerarse que el entrenamiento de un modelo de IA con obras adquiridas legalmente es un “uso justo”, ya que no reproduce la obra de manera literal sino que la transforma en parámetros estadísticos? ¿O se trata, por el contrario, de una forma de explotación que requiere una licencia expresa? Esta ambigüedad legal deja a la industria cultural en una posición de vulnerabilidad frente al avance de la inteligencia artificial, al no existir un consenso claro sobre los límites de esta práctica.
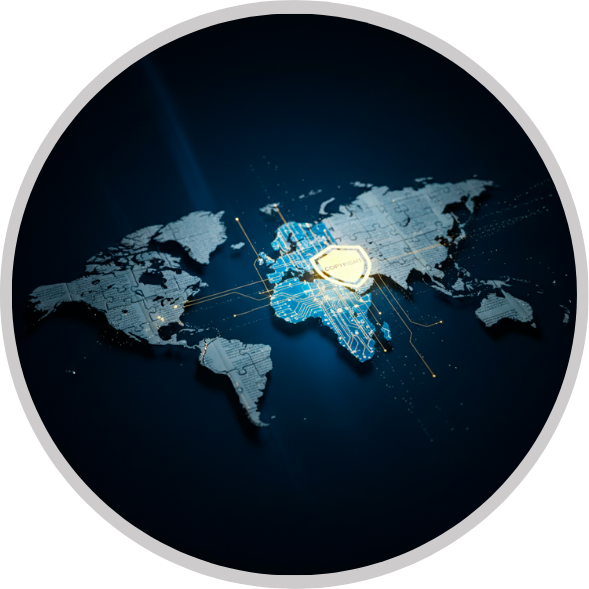
Otro punto crítico es el alcance reducido del acuerdo. Solo se prevé compensación para unas 500.000 obras, cuando los reportes indican que Anthropic habría utilizado hasta siete millones de libros. Además, una cláusula clave restringe el beneficio a los autores cuyas obras estén registradas en la Oficina de Copyright de Estados Unidos, un requisito establecido por la ley federal (17 U.S.C. § 412) para poder litigar y recibir daños y perjuicios. Como consecuencia de este marco legal, miles de escritores y editoriales de otras jurisdicciones, cuyas obras también fueron utilizadas, quedan excluidos del resarcimiento.
Este sesgo territorial refleja un problema global: la protección de los derechos de autor frente a la IA está fragmentada y depende en exceso de marcos nacionales. Mientras no exista una coordinación internacional —al estilo de los mecanismos que impulsa la OMPI en materia de resolución de controversias de IA— los vacíos seguirán siendo aprovechados por las tecnológicas.
El proceso que dio lugar al acuerdo se transformó en acción colectiva (class action) en 2024, tras acreditarse la magnitud de los hechos denunciados. Este mecanismo procesal, característico del derecho estadounidense, permite la acumulación de múltiples reclamaciones individuales en una sola causa, optimizando los recursos judiciales y asegurando un tratamiento uniforme de los derechos afectados.
En términos de distribución, el acuerdo prevé una compensación aproximada de 3.000 dólares por obra, mientras que los honorarios profesionales de los representantes legales alcanzarían alrededor del 25% del monto total. Si bien ello se ajusta a la práctica procesal en materia de class actions, evidencia un aspecto estructural: la asimetría entre el daño ocasionado por la infracción y el quantum indemnizatorio resultante, lo cual pone de manifiesto la insuficiencia de la reparación frente al carácter masivo de la infracción.
Más allá de la dimensión indemnizatoria, la relevancia de la acción colectiva radica en su función ordenadora y precedencial. El caso sienta un parámetro jurídico al penalizar la obtención ilegal del material protegido —en concreto, la descarga masiva desde portales no autorizados— que se utilizó para crear el corpus de entrenamiento. Desde una perspectiva de política pública, este precedente refuerza la necesidad de sanciones proporcionales y con verdadero efecto disuasorio, que eviten que la infracción sistemática del copyright se convierta en un mero costo operativo asumible para las empresas de IA.
El acuerdo preliminar entre Anthropic y los autores demandantes plantea un debate que trasciende lo indemnizatorio: la sostenibilidad de un modelo cultural frente al avance tecnológico. Si la infracción de derechos de autor puede ser internalizada como un costo operativo marginal, el sistema jurídico pierde su capacidad de disuasión efectiva y se transforma en un mecanismo meramente reparador. Ello genera un riesgo sistémico: incentivar la apropiación no autorizada de obras como práctica empresarial estructural.
En este sentido, la reflexión de Jorge Corrales, director de CEDRO, resulta ilustrativa al advertir que la legitimación de estos acuerdos valida, en la práctica, un modelo económico basado en el aprovechamiento de contenidos sin autorización previa. Desde la perspectiva del derecho de autor, ello no solo erosiona los incentivos a la creación, sino que también compromete la sostenibilidad de la cultura como bien jurídico protegido.
En definitiva, el verdadero desafío no reside únicamente en la homologación del acuerdo prevista para abril de 2026, sino en el modelo regulatorio que se consolide posteriormente. La cuestión es si el derecho será capaz de asegurar que la innovación se desarrolle dentro de parámetros lícitos y proporcionales, evitando que la infracción se normalice como estrategia empresarial recurrente.
El caso Bartz v. Anthropic constituye un punto de inflexión en la relación entre propiedad intelectual e inteligencia artificial. No se trata únicamente de un acuerdo millonario, sino de la confirmación de que el sistema jurídico debe adaptarse para responder a nuevas formas de explotación de contenidos culturales. Las sanciones económicas desproporcionadas respecto al daño causado corren el riesgo de consolidarse como un simple costo operativo, lo que debilita la eficacia preventiva del derecho y erosiona la confianza de los autores en los mecanismos de protección existentes.
Desde una perspectiva normativa, resulta imprescindible avanzar hacia un marco que garantice la proporcionalidad de las sanciones y que incorpore mecanismos agravados cuando la infracción sea parte estructural del modelo de negocio. Ello requiere no solo ajustes legislativos internos, sino también una coordinación internacional efectiva, que reduzca la fragmentación regulatoria y evite interpretaciones divergentes sobre doctrinas como el fair use. La labor de organismos como la OMPI, al ofrecer foros de resolución de controversias y promover directrices especializadas, puede ser decisiva para equilibrar innovación y legalidad en el plano global.
En última instancia, el desafío consiste en compatibilizar la evolución tecnológica con la preservación de un ecosistema cultural justo y sostenible. La innovación, para ser legítima, debe desarrollarse bajo el principio de no dañar injustamente, asegurando que el progreso en materia de inteligencia artificial no se construya a costa de la desprotección de los creadores. La respuesta jurídica a este caso sentará las bases de un futuro donde se decida si los derechos de autor son una garantía efectiva o una mera formalidad frente a la expansión de la IA.
La Ley de Inteligencia Artificial (IA) de la Unión Europea, que entró en vigor este 01 de agosto de 2024, esta marcando un hito en la regulación de las tecnologías emergentes. Esta legislación establece un marco normativo integral para la gestión de la IA, reflejando la creciente preocupación por la ética y la seguridad en el uso de tecnologías avanzadas. En un contexto global donde la IA está transformando industrias enteras y afectando profundamente la vida cotidiana, la UE busca garantizar que el desarrollo y la implementación de estos sistemas se realicen de manera responsable y transparente. Esta ley no solo busca proteger a los consumidores y usuarios, sino también fomentar la confianza en la tecnología al asegurar que se utilice de manera ética.
La necesidad de una regulación de la Inteligencia Artificial ha sido impulsada por el rápido avance de la tecnología y su impacto en diversos sectores, desde la atención médica hasta el sector financiero. La UE, como líder en la creación de normativas tecnológicas, ha tomado la iniciativa para establecer un estándar global que pueda ser adoptado por otras jurisdicciones. El marco legislativo de la UE se centra en la protección de derechos fundamentales y la seguridad pública, abordando las preocupaciones sobre la privacidad, la discriminación y la transparencia en el uso de sistemas de IA. La Ley de IA de la UE se presenta como un modelo para el desarrollo de políticas tecnológicas equilibradas y éticas en el ámbito global.
Como lo hemos mencionado antes, la implementación de esta ley se produce en un momento en que la inteligencia artificial está ganando una presencia cada vez mayor en la vida cotidiana. Con la Ley de IA, la UE pretende establecer un marco claro que guíe el desarrollo y uso de estas tecnologías, asegurando que sus beneficios se maximicen mientras se minimizan los riesgos. Esta legislación no solo afecta a los países miembros de la UE, sino que también puede influir en la forma en que otras regiones del mundo abordan la regulación de la IA.

Desde asistentes virtuales hasta algoritmos de recomendación en plataformas de medios sociales, la IA está integrándose en múltiples aspectos de nuestra vida. Es por eso que, la Ley de IA introduce una clasificación de los sistemas de inteligencia artificial en función de su nivel de riesgo. Esta clasificación divide los sistemas en cuatro categorías principales: riesgo inaceptable, alto, limitado y mínimo. Los sistemas clasificados como de riesgo inaceptable, como aquellos que manipulan el comportamiento humano de manera encubierta o que presentan riesgos significativos para los derechos fundamentales, están prohibidos. Esta medida busca prevenir el uso de tecnologías que podrían tener efectos negativos severos en la sociedad y proteger a los individuos de posibles abusos.
Los sistemas de alto riesgo, como aquellos utilizados en la toma de decisiones en ámbitos críticos como la justicia o la contratación laboral, están sujetos a estrictas regulaciones y supervisiones. Estos sistemas deben cumplir con requisitos específicos de transparencia, seguridad y responsabilidad, incluyendo la realización de evaluaciones de impacto y la documentación detallada de su funcionamiento. La ley también establece que las empresas deben implementar mecanismos de supervisión continua para asegurar que los sistemas de IA operen de manera conforme a las normativas y estándares establecidos.
La clasificación también incluye sistemas de riesgo limitado y mínimo, que están sujetos a menos restricciones. Estos sistemas, que generalmente tienen un impacto menor en la vida de los individuos, deben cumplir con requisitos básicos de transparencia y documentación, pero no están sujetos a las mismas regulaciones estrictas que los sistemas de alto riesgo. La estructura de clasificación permite una regulación proporcional que se adapta a la naturaleza y el impacto de los sistemas de IA, equilibrando la innovación con la protección de los derechos
Uno de los principales puntos que aborda la Ley de IA, es el requisito de transparencia. Las empresas que desarrollan o implementan sistemas de inteligencia artificial deben proporcionar información clara y accesible sobre el uso de dichas tecnologías. Esto incluye detalles sobre el propósito del sistema, los datos utilizados y cómo se toman las decisiones basadas en la IA. La transparencia es crucial para permitir que los usuarios y consumidores comprendan cómo se utilizan sus datos y cómo los sistemas afectan su realidad, lo que a su vez buscan fomenta la confianza en las tecnologías emergentes.
La ley exige que los sistemas de IA informen a los usuarios cuando están interactuando con una máquina en lugar de una persona. Además, se requiere que las empresas expliquen los mecanismos de toma de decisiones automatizados y cómo estos pueden influir en los resultados o recomendaciones que reciben los distintos usuarios. La obligación de transparencia está diseñada para evitar que los sistemas de IA operen de manera opaca, lo que podría llevar a la desinformación y a la falta de confianza en la tecnología.
La implementación de estos requisitos de transparencia también implica que las empresas deben desarrollar documentación detallada y accesible sobre sus sistemas de IA. Esto incluye mantener registros de los datos utilizados, las decisiones tomadas por los sistemas y cualquier impacto potencial en los derechos de los usuarios. La ley establece que esta documentación debe estar disponible para las revisión de las autoridades de supervisión y, en algunos casos, para los propios usuarios, garantizando que la información relevante sobre la IA sea comprensible.
La Ley impone una serie de obligaciones de conformidad a las empresas que desarrollan o implementan sistemas de IA. Estas obligaciones incluyen la realización de evaluaciones de impacto para identificar y mitigar los riesgos asociados con el uso de la IA. Las empresas deben evaluar cómo sus sistemas afectan a los derechos de los individuos y tomar medidas para reducir cualquier impacto negativo. Este enfoque preventivo asegura que los riesgos sean identificados y abordados antes de que los sistemas se pongan en funcionamiento.
Además, las empresas deben mantener registros detallados de los datos utilizados por sus sistemas de IA, así como de los procesos de toma de decisiones automatizados. Esta documentación es esencial para garantizar la trazabilidad y la responsabilidad en el uso de la Inteligencia Artificial. Como se menciono anteriormente, las autoridades de supervisión tendrán acceso a esta información para verificar el cumplimiento de la ley y para investigar cualquier posible incumplimiento. La obligación de documentación también facilita la evaluación continua de los sistemas de IA y los ajustes a las normativas vigentes.
La ley también menciona que las empresas implementen mecanismos de supervisión continua para asegurar que sus sistemas de IA permanezcan en conformidad con los requisitos legales. Esto incluye la realización de auditorías periódicas y la actualización de los sistemas en función de los cambios en la legislación o en las condiciones operativas. La capacidad de adaptación y la vigilancia constante son fundamentales para garantizar que los sistemas de IA se mantengan alineados con las expectativas legales y éticas.
La Ley de IA tambien establece un marco robusto para la supervisión y la aplicación de las regulaciones. Las autoridades nacionales de cada estado miembro de la Unión Europea serán responsables de vigilar la implementación y el cumplimiento de la normativa. Estas autoridades tendrán el poder de realizar inspecciones, solicitar información e imponer sanciones a las empresas que no cumplan con los requisitos establecidos. La supervisión efectiva es crucial para asegurar que la ley se aplique de manera uniforme y para prevenir el incumplimiento.
Las sanciones por incumplimiento de la ley pueden ser significativas e incluyen multas sustanciales, así como la suspensión o prohibición de operaciones para los sistemas de IA que no cumplan con los requisitos. Estas medidas están diseñadas para incentivar a las empresas a cumplir con las normativas y para asegurar que se tomen en serio las obligaciones legales. La posibilidad de sanciones severas refuerza la importancia de la conformidad y la responsabilidad en el uso de la IA.
Además, la Ley de IA fomenta la cooperación entre las autoridades de supervisión de diferentes países de la UE para garantizar una aplicación coherente y coordinada de la normativa. Esta colaboración es esencial para abordar desafíos transfronterizos y para asegurar que las empresas operen bajo un marco regulatorio uniforme en toda la región. La cooperación internacional también puede influir en la creación de normas globales para la regulación de la Inteligencia Artificial.

La entrada en vigor de la Ley de IA tiene fuertes implicaciones para el derecho corporativo en la UE. Las empresas deben adaptarse a un entorno legal más exigente y proactivo en la gestión de riesgos asociados con la IA. La necesidad de cumplir con requisitos de transparencia y realizar evaluaciones de impacto modificará la forma en que las corporaciones diseñan, implementan y monitorean sus tecnologías. Esto no solo afectará la operación diaria de las empresas, sino que también influirá en sus estrategias de cumplimiento y gestión de riesgos.
Además, la ley incentivará a las empresas a adoptar prácticas de IA responsables y éticas, promoviendo un entorno empresarial más transparente y orientado hacia la protección de los derechos del consumidor. La vigilancia y las posibles sanciones por incumplimiento también fomentarán una mayor diligencia en la conformidad con las normativas, impactando en la forma en que las empresas manejan sus operaciones relacionadas con la IA.
La implementación de la Ley de IA de la UE abre perspectivas para la regulación y el desarrollo de tecnologías emergentes. A medida que la tecnología asociada con la Inteligencia Artificial continúa avanzando, es probable que la ley evolucione para abordar nuevos desafíos y oportunidades. La experiencia adquirida durante la implementación de la normativa permitirá realizar ajustes y mejoras en la regulación, asegurando que se mantenga relevante y efectiva en el contexto de un entorno tecnológico en constante cambio.
Además, la Ley de IA de la UE podría servir como un modelo para otras regiones y países que buscan establecer sus propias normativas sobre inteligencia artificial. La influencia de la Union Europea en la regulación global de la IA podría fomentar una mayor armonización de las políticas y promover la adopción de estándares similares en todo el mundo. Esto puede facilitar la cooperación internacional en la gestión de tecnologías emergentes y contribuir a un enfoque más coordinado para abordar los desafíos asociados con la IA.
En el futuro, es probable que la Ley de IA también impulse la innovación y el desarrollo de nuevas soluciones tecnológicas. Al establecer un marco claro para el uso responsable de la IA, la normativa puede fomentar la confianza en las tecnologías emergentes y estimular la inversión en investigación y desarrollo. La combinación de una regulación efectiva con un entorno propicio para la innovación puede contribuir a un futuro en el que la inteligencia artificial se utilice de manera beneficiosa y ética en diversas áreas de la vida y la economía (Xataka, 2024).
Comisión Europea. (2024). Ley de Inteligencia Artificial de la Unión Europea.
Expreso. (2024). Ley de Inteligencia Artificial entra en vigor en UE: cinco claves.
Bae Negocios. (2024). La Unión Europea puso en vigencia su Ley de Inteligencia Artificial.
Europarl. (2024). Ley de IA de la UE: primera normativa sobre inteligencia artificial.
Xataka. (2024). Ley de IA europea entra hoy en vigor: cómo se va a aplicar.
La Ley de Inteligencia Artificial, cuyo objetivo es establecer un marco normativo único para los sistemas de IA que operen en la Unión Europea, mitigando riesgos para la seguridad y los derechos fundamentales de los ciudadanos. Este reglamento, que excluye el sector militar, tiene el potencial de convertirse en una referencia global, similar al Reglamento General de Protección de Datos (RGPD).
La Ley de Inteligencia Artificial es el primer intento global de regular la IA, clasificando sus aplicaciones según el riesgo y estableciendo prohibiciones específicas para aplicaciones de alto riesgo, como el reconocimiento biométrico a distancia y la manipulación subliminal. La normativa se aplicará de forma gradual hasta su plena entrada en vigor en 2026.
Un apartado dentro del reglamento destaca la necesidad de apoyar a las pequeñas y medianas empresas (PYMES), empresas emergentes y usuarios en su adaptación a este nuevo marco regulatorio. Este artículo explora las actividades de sensibilización y desarrollo de competencias digitales propuestas, destacando su relevancia y beneficios para estos actores clave.

En el reglamento sobre sistemas de Inteligencia Artificial (IA), se proponen diversas actividades de sensibilización y desarrollo de competencias digitales específicamente dirigidas a las PYMES, empresas emergentes y usuarios. Equipar a las PYMES y empresas emergentes con habilidades digitales avanzadas permite a estas entidades aprovechar mejor las oportunidades que ofrece la IA, mejorando su competitividad e innovación.
Este enfoque asegura que tanto el sector educativo como el empresarial estén alineados en sus objetivos de digitalización, promoviendo una transición más fluida hacia la adopción de tecnologías de IA. Estas iniciativas tienen como objetivo mejorar la preparación y concienciación de estos actores clave, promoviendo un uso responsable y ético de la IA. A continuación, se detallan algunas de las propuestas más relevantes.
El despliegue de sistemas de IA en el ámbito educativo y empresarial es importante a la hora de fomentar una formación digital de alta calidad. Esto permitirá que tanto los empleados de PYMES y empresas emergentes como los estudiantes y profesores adquieran y compartan las capacidades y competencias digitales necesarias, incluyendo la alfabetización mediática y el pensamiento crítico. Estas habilidades son esenciales para que los individuos participen activamente en la economía, la sociedad y los procesos democráticos.
Para las PYMES y empresas emergentes, es crucial incorporar la alfabetización mediática y el pensamiento crítico en sus estrategias de formación y desarrollo. La Carta Iberoamericana de Inteligencia Artificial del CLAD subraya la importancia de estas competencias para enfrentar los desafíos y aprovechar las oportunidades que ofrece la IA . Equipar a las PYMES con estas habilidades mejora su capacidad para innovar, adaptarse a los cambios tecnológicos y competir en un mercado cada vez más digitalizado.
No obstante, es esencial gestionar los sistemas de IA con cuidado, especialmente aquellos clasificados como de alto riesgo. Esto incluye sistemas que determinan el acceso a programas educativos o laborales, distribuyen a las personas entre distintas instituciones o empresas, evalúan el desempeño o influyen significativamente en las oportunidades de desarrollo profesional. Estos sistemas tienen el potencial de decidir la trayectoria formativa y profesional de una persona, afectando directamente su capacidad para asegurar su subsistencia. Si no se diseñan y utilizan correctamente, pueden invadir derechos fundamentales como el derecho a la educación, la formación y el empleo, perpetuando patrones históricos de discriminación.
Por ello, el desarrollo y la implementación de sistemas de IA en la educación y en las PYMES deben ser cuidadosamente monitoreados y regulados para evitar abusos y garantizar que se utilicen de manera justa y ética. Las medidas de alfabetización mediática y pensamiento crítico no solo empoderan a los miembros de una empresa o a estudiantes, sino que también establecen una base sólida para la evaluación crítica y el uso responsable de la tecnología de IA en todos los contextos.

El Reglamento también propone fomentar la adquisición y compartición de competencias digitales necesarias en el ámbito educativo. Este enfoque es integral, abarcando tanto a estudiantes como a profesores, y busca asegurar que todos los involucrados en el proceso educativo estén equipados con las habilidades digitales necesarias para adaptarse a un entorno tecnológico en constante evolución.
Las competencias digitales incluyen no solo la capacidad de utilizar herramientas tecnológicas, sino también la comprensión de sus implicaciones éticas y sociales. Esto es importante en la IA, donde las decisiones automatizadas pueden tener efectos significativos en la vida de las personas. Al equipar a estudiantes y profesores con estas competencias, se promueve una cultura de aprendizaje continuo y adaptación, esencial para la integración efectiva de la IA en la educación.
Además, fomentar estas competencias facilita la creación de una base sólida de conocimientos que pueden transferirse y aplicarse en el contexto empresarial. Las PYMES y empresas emergentes, al contar con personal educado en competencias digitales, pueden aprovechar mejor las oportunidades que ofrece la IA, mejorando su competitividad y capacidad de innovación. Este enfoque holístico asegura que el ecosistema educativo y empresarial estén alineados en sus objetivos de digitalización y adopción de IA.
Se anima a los proveedores y responsables del despliegue de sistemas de IA a aplicar requisitos adicionales voluntarios relacionados con la sostenibilidad medioambiental, la inclusividad y la diversidad en el diseño y desarrollo de sistemas de IA. Esto incluye la participación de partes interesadas y la diversidad de los equipos de desarrollo, promoviendo la paridad de género.
La adopción de estos requisitos voluntarios no solo mejora la ética y la responsabilidad en el desarrollo de IA, sino que también puede aumentar la aceptación y la confianza del público en estas tecnologías. Por ejemplo, considerar la sostenibilidad medioambiental en el desarrollo de sistemas de IA puede ayudar a mitigar los impactos negativos en el medio ambiente, promoviendo una tecnología más verde y sostenible.
Además, la inclusión y la diversidad en los equipos de desarrollo y en el diseño de sistemas de IA aseguran que las perspectivas y necesidades de diferentes grupos sociales sean consideradas. Esto es crucial para evitar sesgos y discriminación en los algoritmos de IA, y para garantizar que los beneficios de la tecnología sean accesibles para todos. Al fomentar la participación de una variedad de partes interesadas, desde organizaciones empresariales hasta la sociedad civil, se crea un ecosistema más inclusivo y equitativo.
Otra punto clave es el establecimiento de herramientas de alfabetización en materia de inteligencia artificial. Estas herramientas están diseñadas para garantizar el cumplimiento adecuado y la correcta ejecución de los sistemas de IA, además de promover la sensibilización pública y la comprensión de los beneficios, riesgos, salvaguardias, derechos y obligaciones asociados con el uso de la IA.
Estas herramientas de alfabetización en IA proporcionarán a proveedores, responsables del despliegue y usuarios los conceptos necesarios para tomar decisiones informadas. Esto incluye entender cómo aplicar correctamente los elementos técnicos durante el desarrollo del sistema de IA, las medidas a implementar durante su uso, y cómo interpretar adecuadamente la información generada por el sistema de IA. También es esencial que las personas afectadas por decisiones automatizadas comprendan cómo estas decisiones impactan sus vidas.
La implementación generalizada de estas herramientas y medidas de alfabetización en IA contribuirá a mejorar las condiciones de trabajo y sostener la consolidación y la senda de innovación de una IA fiable en la Unión. El Comité Europeo de Inteligencia Artificial apoyará a la Comisión en la promoción de estas herramientas, fomentando una mayor comprensión y conciencia pública sobre el uso responsable y ético de la IA.
El Reglamento sobre sistemas de IA subrayan la importancia de apoyar a las PYMES, empresas emergentes y usuarios en su adaptación al nuevo marco regulatorio. Las iniciativas propuestas buscan fomentar una educación digital integral, que incluya no solo habilidades técnicas, sino también competencias críticas como la alfabetización mediática y el pensamiento crítico. La correcta implementación de sistemas de IA en el ámbito educativo, con un enfoque en la ética y la equidad, es esencial para evitar la perpetuación de discriminaciones y garantizar un acceso justo a las oportunidades educativas.
El fomento de competencias digitales en el ámbito empresarial es igualmente crucial. Equipar a las PYMES y empresas emergentes con habilidades avanzadas en IA no solo mejora su competitividad, sino que también promueve un entorno de innovación y adaptación constante. Al alinear los objetivos educativos y empresariales, se asegura una transición más fluida y efectiva hacia la adopción de tecnologías, beneficiando a todo el ecosistema.
Finalmente, la promoción de requisitos voluntarios adicionales y el establecimiento de herramientas de alfabetización en IA son pasos vitales para garantizar un desarrollo y uso responsable de la IA. Estas medidas no solo aumentan la confianza del público en la tecnología, sino que también aseguran que sus beneficios sean equitativamente distribuidos. La cooperación entre diversos actores, desde proveedores hasta usuarios finales, es esencial para crear un entorno inclusivo y ético en este ámbito.
Centro Latinoamericano de Administración para el Desarrollo. (2023). Carta Iberoamericana de Inteligencia Artificial [Versión 2].
Comisión Europea. (2021). Propuesta de Reglamento del Parlamento Europeo y del Consejo por el que se establecen normas armonizadas en materia de inteligencia artificial (Ley de Inteligencia Artificial) y se modifican determinados actos legislativos de la Unión.
Comisión Europea. (2023). Informe A9-0188/2023 sobre la Propuesta de Reglamento del Parlamento Europeo y del Consejo por el que se establecen normas armonizadas en materia de inteligencia artificial (Ley de Inteligencia Artificial).
Parlamento Europeo. (2024). Enmiendas al Reglamento sobre sistemas de Inteligencia Artificial. Obtenido de Documento TA-9-2024-0138.
Unión Europea. (2024). Opinión del Comité Económico y Social sobre la Propuesta de Reglamento del Parlamento Europeo y del Consejo por el que se establecen normas armonizadas en materia de inteligencia artificial (Ley de Inteligencia Artificial). Obtenido de CESE 2021/02482.
Unión Europea. (2024). Opinión del Comité de las Regiones sobre la Propuesta de Reglamento del Parlamento Europeo y del Consejo por el que se establecen normas armonizadas en materia de inteligencia artificial (Ley de Inteligencia Artificial). Obtenido de CDR 2021/02682.
En los últimos años, la evolución de la Inteligencia Artificial (IA) abrió un nuevo capítulo en la historia de la tecnología contemporánea, con una amplia gama de aplicaciones que abarcan desde la optimización de procesos hasta la toma de decisiones en diversos ámbitos como la salud y la seguridad. Sin embargo, este avance ha suscitado crecientes inquietudes sobre cuestiones éticas y de responsabilidad en su desarrollo y aplicación.
En respuesta a estos desafíos, el Parlamento Europeo y el Consejo han aprobado, el 13 de marzo de 2024, una legislación pionera: el Reglamento del Parlamento Europeo y del Consejo sobre Inteligencia Artificial. La legislación, presentada por la Comisión Europea en abril de 2021, busca establecer un marco normativo único para los sistemas de IA que operan en la Unión Europea, para mitigar los riesgos a la seguridad y proteger los derechos de los ciudadanos.
La legislación establece prohibiciones claras sobre ciertas aplicaciones de IA que podrían socavar los derechos de los ciudadanos, como el reconocimiento biométrico a distancia y la manipulación subliminal del comportamiento humano. Estas restricciones reflejan un compromiso firme con la protección de la privacidad y la dignidad humana en el uso de la IA.
Por ese motivo, una de las características de este reglamento es su enfoque en la clasificación de las aplicaciones de IA según el nivel de riesgo que representan. Si bien las aplicaciones de bajo riesgo no estarán sujetas a regulación, las de riesgo medio y alto requerirán una evaluación obligatoria de conformidad antes de su comercialización, con énfasis en la transparencia y la responsabilidad por parte de los proveedores.
El Reglamento sobre sistemas de Inteligencia Artificial propone un enfoque claro y detallado para la evaluación de sistemas de IA, comenzando por la provisión de una descripción precisa de la finalidad prevista para su utilización. La descripción abarca aspectos cruciales, incluyendo el propósito principal del sistema de IA, como su función específica en un contexto médico para el diagnóstico de enfermedades. Además, se requieren especificar los objetivos que se esperan alcanzar con el sistema, lo que facilita medir su éxito en términos de eficiencia, precisión y reducción de costos operativos.
Es esencial también identificar a los beneficiarios directos y a los usuarios finales del sistema de IA, entendiendo quiénes se verán impactados por su implementación y quiénes interactuarán con él en la práctica. Este conocimiento contribuye a diseñar una solución que se adapte a las necesidades y expectativas de todas las partes involucradas. Además, la descripción de la finalidad prevista debe abordar el alcance del sistema, es decir, sus capacidades y las situaciones en las que puede ser utilizado, así como reconocer sus limitaciones, como posibles sesgos o áreas de incertidumbre.
En resumen, al proporcionar una descripción clara de la finalidad prevista de un sistema de IA, se sientan las bases para su desarrollo, implementación y evaluación efectivos. Definir el propósito, los objetivos, los beneficiarios, el alcance y las limitaciones del sistema garantiza que su utilización sea coherente con las expectativas y necesidades de todas las partes interesadas, promoviendo así una adopción responsable y ética de la inteligencia artificial.
El enfoque del Reglamento sobre sistemas de Inteligencia Artificial para la evaluación de sistemas de IA destaca la importancia de comprender el ámbito geográfico y temporal de su utilización. Esta evaluación detallada implica una consideración exhaustiva de varios aspectos clave, comenzando por la definición clara del ámbito geográfico donde se implementará y utilizará el sistema de IA. Identificar si el sistema operará a nivel local, nacional, regional o internacional es crucial, así como tener en cuenta las regulaciones y leyes específicas de cada jurisdicción involucrada.
Además, se requiere una definición precisa de la duración prevista de la utilización del sistema, ya sea de forma continua o temporal para proyectos específicos. Esta determinación no solo afecta la planificación operativa, sino también la programación de mantenimiento, actualizaciones y evaluaciones periódicas del sistema. Además, se deben considerar las posibles expansiones futuras del sistema y los cambios en la demanda o las condiciones operativas que podrían afectar su utilización a largo plazo.
En resumen, el análisis detallado del ámbito geográfico y temporal de utilización de un sistema de IA busca garantizar una comprensión completa de los contextos operativos. Esto permite una planificación adecuada, el cumplimiento de regulaciones locales y la adaptabilidad a posibles cambios en el entorno operativo a lo largo del tiempo. Este enfoque contribuye a una implementación más efectiva y responsable de la inteligencia artificial en diversos sectores y geografías.

Al evaluar el impacto en los derechos fundamentales al utilizar un sistema de Inteligencia Artificial (IA), es fundamental garantizar que su implementación cumpla con el marco legal establecido a nivel de la Unión Europea en lo que respecta a los derechos fundamentales. Esta evaluación implica considerar varios aspectos y las leyes nacionales en materia de derechos fundamentales, garantizando así el respeto a principios como la privacidad, la no discriminación y otros derechos protegidos. Además, se requiere realizar una evaluación exhaustiva del impacto razonablemente previsible en los derechos fundamentales, identificando cómo el uso del sistema podría afectar aspectos como la igualdad de trato, la libertad de expresión y la autonomía individual.
Durante esta evaluación, es crucial identificar los posibles riesgos y efectos negativos que el sistema de IA podría tener en los derechos fundamentales de las personas. Esto incluye considerar aspectos como la discriminación algorítmica, la falta de transparencia en las decisiones automatizadas y el impacto en la dignidad humana. Una vez identificados estos riesgos, es importante desarrollar un plan detallado para mitigarlos, lo que implica la integración de salvaguardias técnicas, la supervisión continua del sistema y la adopción de medidas correctivas en caso de violaciones de derechos.
La evaluación del impacto en los derechos fundamentales al utilizar un sistema de IA busca garantizar que su implementación se realice de manera ética, legal y respetuosa con los principios fundamentales de los derechos humanos. Esta evaluación proactiva es esencial para prevenir posibles violaciones de derechos y promover un uso responsable y ético de la IA en la sociedad, asegurando así que la tecnología beneficie a todos los individuos de manera equitativa y justa.
El enfoque presentado por el Reglamento sobre sistemas de Inteligencia Artificial insta a evaluar las repercusiones negativas previsibles del uso del sistema de IA en el medio ambiente. Esta evaluación busca comprender y mitigar el impacto ambiental de la tecnología, considerando aspectos como el consumo de energía, la generación de residuos electrónicos y la conservación de recursos naturales. Además, se destaca la importancia de considerar cómo el sistema de IA puede contribuir a la sostenibilidad ambiental y al cumplimiento de compromisos como el Pacto Verde Europeo.
Para evaluar adecuadamente las repercusiones ambientales del sistema de IA, es esencial considerar su eficiencia energética y el uso de recursos en su ciclo de vida. Esto implica identificar oportunidades para optimizar el consumo de energía y reducir la huella ambiental del sistema, así como gestionar de manera adecuada la generación de residuos electrónicos mediante prácticas de reutilización, reciclaje y disposición responsable.
Además de evaluar las posibles repercusiones negativas, es crucial considerar cómo el sistema de IA puede contribuir activamente a la sostenibilidad ambiental. La tecnología de IA puede usarse para optimizar procesos, reducir el consumo de recursos y apoyar iniciativas de conservación ambiental, una herramienta clave en la transición hacia una economía más verde y respetuosa con el medio ambiente. Evaluar cómo el uso del sistema de IA se alinea con los compromisos ambientales, como el Pacto Verde Europeo, es fundamental para garantizar un desarrollo tecnológico responsable y compatible con la protección del entorno natural.

La respuesta legislativa de la Unión Europea, con el Reglamento sobre Inteligencia Artificial, establece un marco normativo integral para mitigar riesgos y proteger los derechos fundamentales de los ciudadanos. Este reglamento se centra en clasificar las aplicaciones de IA según su nivel de riesgo y exige una evaluación exhaustiva de conformidad antes de su comercialización.
Una de las principales medidas es la descripción detallada de la finalidad prevista de los sistemas de IA, garantizando transparencia y responsabilidad en su desarrollo y aplicación. Además, se enfoca en comprender el ámbito geográfico y temporal de utilización de estos sistemas, asegurando su adaptabilidad a diferentes contextos y regulaciones. Se destaca la evaluación del impacto en los derechos fundamentales, buscando prevenir violaciones éticas y legales mediante la identificación y mitigación de posibles riesgos.
Por último, se consideran las repercusiones ambientales del uso de la IA, promoviendo prácticas sostenibles y su alineación con compromisos como el Pacto Verde Europeo. En conjunto, estas medidas buscan garantizar un desarrollo y aplicación ética, responsable y compatible con la protección del medio ambiente. En los próximos artículos seguiremos explorando estos temas enfocándonos en cómo el reglamento influirá en la implementación y supervisión de sistemas de IA en la sociedad contemporánea, que seguramente se adaptará a los avances y será el marco jurídico de referencia internacional.
Unión Europea. (13 de Marzo de 2024). REGULATION OF THE EUROPEAN PARLIAMENT AND OF THE COUNCIL LAYING DOWN HARMONISED RULES ON ARTIFICIAL INTELLIGENCE (ARTIFICIAL INTELLIGENCE ACT) AND AMENDING CERTAIN UNION LEGISLATIVE ACTS.
Unión Europea. (09 de Diceimbre de 2023). Reglamento de Inteligencia Artificial: el Consejo y el Parlamento alcanzan un acuerdo sobre las primeras normas del mundo en materia de inteligencia artificial.
Parlamento Europeo. (15 de Marzo de 2024). La Eurocámara aprueba Reglamento de Inteligencia Artificial.
La integración de la inteligencia artificial (IA) en el ámbito del derecho corporativo ha generado debates en los últimos años. Reconocidos expertos en la materia, como Richard Susskind, han identificado el potencial transformador de la IA en el sector legal, aunque advierten sobre la necesidad de evitar exageraciones respecto a sus efectos a corto plazo. No obstante, Susskind sugiere que, a largo plazo, la IA tendrá un impacto significativo en los servicios legales y judiciales.
La IA, representada por diversas tecnologías generativas, no solo promete mejorar la eficiencia operativa, sino que también plantea desafíos éticos y regulatorios. Aunque aún se encuentra en las primeras etapas de su desarrollo, se anticipa que las próximas generaciones de sistemas de IA serán aún más capaces y precisas.
Es esencial comprender que la IA en el ámbito del derecho es parte de una evolución continua que se remonta a décadas atrás. Los sistemas de IA más recientes, como la IA generativa, no reemplazan a sus predecesores, sino que amplían el conjunto de herramientas disponibles para los profesionales del derecho. Se espera que estos avances continúen en el futuro, con un ritmo de desarrollo acelerado gracias a los avances tecnológicos.
El futuro de la IA en el derecho ofrece tanto oportunidades como desafíos. Aunque la tecnología puede mejorar la eficiencia y la productividad de los abogados in-house, también plantea cuestiones sobre el equilibrio entre la automatización y el juicio humano, así como sobre la responsabilidad ética y legal en el uso de estas herramientas. En última instancia, el impacto de la IA en el derecho dependerá de cómo se gestionen estos desafíos y se aprovechen las oportunidades para promover una práctica legal más eficiente, ética y centrada en el cliente.
Dentro del derecho corporativo, la implementación de la inteligencia artificial (IA) ha provocado una transformación notable en la gestión de los procesos legales empresariales. Entre las diversas aplicaciones prácticas de la IA, destaca la automatización de tareas rutinarias mediante el procesamiento del lenguaje natural (NLP). Esta tecnología avanzada permite a los abogados realizar revisiones exhaustivas de grandes volúmenes de documentos legales con eficiencia y precisión, identificando información relevante como fechas límite, posibles incumplimientos en la práctica.
Las herramientas de NLP también facilitan la extracción de información específica de los documentos legales, lo que posibilita a los profesionales jurídicos generar resúmenes ejecutivos y análisis detallados con mayor rapidez y precisión. Además, el uso de plantillas y formularios predefinidos, alimentados por IA, agiliza la creación de documentos legales estándar y personalizados, como contratos y acuerdos corporativos.
La tecnología de IA, representada por sistemas como los chatbots, ofrece una variedad de aplicaciones prácticas, desde la investigación jurídica general hasta la redacción simplificada de documentos legales complejos, los chatbots de IA generativa pueden mejorar significativamente la eficiencia y la velocidad de las tareas legales cotidianas. Esto proporciona beneficios tangibles tanto para los clientes como para los abogados, permitiendo una gestión más ágil y precisa de los asuntos legales de la empresa.
A pesar de los avances en la IA y el NLP, es importante tener en cuenta los límites de esta tecnología. Si bien puede automatizar tareas repetitivas y reducir errores, la interpretación y el análisis crítico de los abogados siguen siendo fundamentales en la práctica legal. Además, la calidad de los resultados obtenidos por las herramientas de IA depende en gran medida de la calidad de los datos utilizados para entrenarlas, lo que subraya la importancia de la selección y preparación cuidadosa de los conjuntos de datos utilizados en la práctica legal.
El procesamiento del lenguaje natural (NLP) ha experimentado una notable evolución en los últimos años, impulsada por el creciente interés en mejorar la comunicación con la IA, así como por los avances en tecnologías como el big data, la computación potente y los algoritmos mejorados. Esta disciplina, que permite a las computadoras entender, interpretar y manipular el lenguaje humano, se nutre de diversas áreas como la ciencia de la computación y la lingüística computacional, con el objetivo de cerrar la brecha entre la comunicación humana y el entendimiento de las máquinas.
La importancia del procesamiento del lenguaje natural radica en su capacidad para manejar grandes volúmenes de datos textuales y estructurar fuentes de datos altamente no estructuradas. Gracias a la NLP, las computadoras pueden comunicarse en el lenguaje humano, interpretar texto escrito y voz hablada, medir el sentimiento y determinar la relevancia de la información. Esto permite analizar datos basados en lenguajes de manera eficiente, sin fatigarse e imparcial, lo que resulta fundamental por la enorme cantidad de datos no estructurados generados diariamente.
El lenguaje humano es extremadamente complejo y diverso, con una variedad de idiomas, dialectos, reglas gramaticales y términos coloquiales. La NLP aborda esta complejidad al resolver la ambigüedad del lenguaje y agregar estructura numérica útil a los datos. Aunque el aprendizaje supervisado y no supervisado, así como el aprendizaje profundo, son ampliamente utilizados para modelar el lenguaje humano, la NLP complementa estos métodos al proporcionar un entendimiento sintáctico y semántico que es crucial para aplicaciones como el reconocimiento del habla y la analítica de texto. En resumen, el procesamiento del lenguaje natural es fundamental en la capacidad de las máquinas para interactuar con el lenguaje humano y comprender la información de grandes volúmenes de datos textuales.
La adopción de la IA en el trabajo legal también enfrenta desafíos y limitaciones significativas. Uno de los principales desafíos es garantizar la transparencia y la explicabilidad de los algoritmos utilizados en los sistemas de IA. Esto es especialmente importante en el contexto jurídico, donde las decisiones deben ser comprensibles o cuestionables por los profesionales.
Además, la IA puede introducir sesgos y errores en el proceso legal si no se implementa correctamente. Los algoritmos de IA aprenden de los datos con los que son entrenados, lo que significa que pueden perpetuar sesgos existentes en los datos o generar resultados inexactos si los datos de entrenamiento son incompletos o incorrectos.
Otro desafío importante es la privacidad y la seguridad de los datos. La IA en el derecho corporativo a menudo implica el procesamiento de grandes cantidades de datos confidenciales, como información financiera y datos personales. Es fundamental garantizar que estos datos estén protegidos contra accesos no autorizados y que se cumplan todas las regulaciones de privacidad aplicables.
Respecto a estos desafíos, podemos observar que la propuesta del Reglamento del Parlamento Europeo y del Consejo por el que se establecen normas armonizadas sobre IA, ya aborda entre otros aspectos, el establecimiento de requisitos que van desde la exigencia de la descripción detallada de los elementos del sistema de IA y del proceso, esto es la lógica general del sistema de IA y de los algoritmos, así como busca garantizar la intimidad y la protección de datos personales a lo largo del ciclo de vida del sistema, con el cumplimiento de los principios de minimización de datos y la protección desde el diseño y por defecto, que pueden incluir tanto la anonimización y el cifrado, así como el uso de tecnología que permita llevar algoritmos a los datos.
En resumen, si bien la inteligencia artificial ofrece numerosos beneficios, también plantea desafíos importantes que deben abordarse para garantizar su implementación efectiva y ética. Es fundamental que los profesionales jurídicos trabajen en colaboración con expertos en tecnología para desarrollar soluciones que sean transparentes, equitativas y respetuosas de los derechos y la privacidad de las personas.
Committee on the Internal Market and Consumer Protection & Committee on Civil Liberties, Justice and Home Affairs. (2024). Provisional agreement resulting from interinstitutional negotiations.
Call, X. (26 de Febrero | de 2024). La IA en el derecho corporativo: qué es el NLP.
Molina, S. (16 de Octubre de 2023). La Inteligencia Artificial generativa en el sector legal.
SAS. (s.f.). Procesamiento del lenguaje natural (NLP).
Estalella, J. (27 de Febrero de 2024). ¿Burbuja de Inteligencia Artificial en el sector legal?